13 半监督学习
让学习过程不依赖外界的咨询交互,自动利用未标记样本所包含的分布信息的方法便是半监督学习。
13.1 未标记样本
我们有训练样本集
主动学习
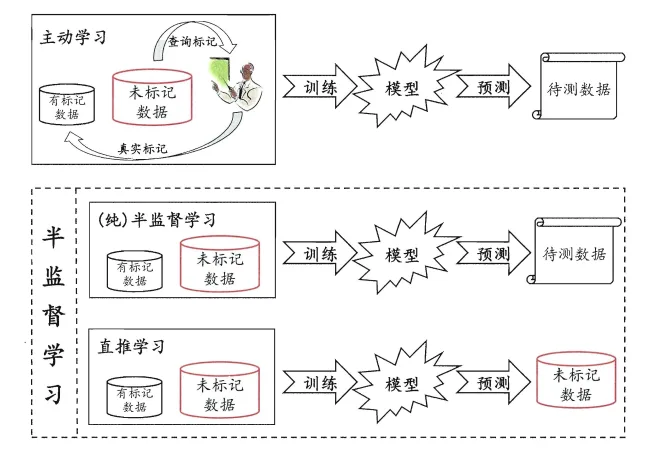
一种简单的做法是通过专家知识对这些未标记的样本进行打标,但随之而来的就是巨大的人力耗费。若我们先使用有标记的样本数据集训练出一个学习器,再基于该学习器对未标记的样本进行预测,从中挑选出不确定性高或分类置信度低的样本来咨询专家并进行打标,最后使用扩充后的训练集重新训练学习器,这样便能大幅度降低标记成本,这便是主动学习(active learning),其目标是使用尽量少的/有价值的咨询来获得更好的性能。
显然,主动学习需要与外界进行交互/查询/打标,其本质上仍然属于一种监督学习。事实上,无标记样本虽未包含标记信息,但它们与有标记样本一样都是从总体中独立同分布采样得到,因此它们所包含的数据分布信息对学习器的训练大有裨益。如何让学习过程不依赖外界的咨询交互,自动利用未标记样本所包含的分布信息的方法便是半监督学习(semi-supervised learning),即训练集同时包含有标记样本数据和未标记样本数据。

此外,半监督学习还可以进一步划分为纯半监督学习和直推学习,两者的区别在于:前者假定训练数据集中的未标记数据并非待预测数据,而后者假定学习过程中的未标记数据就是待预测数据。
13.2 生成式方法
生成式方法(generative methods)是基于生成式模型的方法,即先对联合分布
其中
不失一般性,假设类簇与真实的类别按照顺序一一对应,即第
其中
直观上来看,基于半监督的高斯混合模型有机地整合了贝叶斯分类器与高斯混合聚类的核心思想,有效地利用了未标记样本数据隐含的分布信息,从而使得参数的估计更加准确。同样地,这里也要召唤出之前的EM大法进行求解,首先对各个高斯混合成分的参数及混合系数进行随机初始化,计算出各个PM(即
其中
当参数迭代更新收敛后,对于待预测样本x,便可以像贝叶斯分类器那样计算出样本属于每个类簇的后验概率,接着找出概率最大的即可:
可以看出:基于生成式模型的方法十分依赖于对潜在数据分布的假设,即假设的分布要能和真实分布相吻合,否则利用未标记的样本数据反倒会在错误的道路上渐行渐远,从而降低学习器的泛化性能。因此,此类方法要求极强的领域知识和掐指观天的本领。
13.3 半监督SVM
监督学习中的SVM试图找到一个划分超平面,使得两侧支持向量之间的间隔最大,即“最大划分间隔”思想。对于半监督学习,S3VM则考虑超平面需穿过数据低密度的区域。TSVM是半监督支持向量机中的最著名代表,其核心思想是:尝试为未标记样本找到合适的标记指派,使得超平面划分后的间隔最大化。TSVM采用局部搜索的策略来进行迭代求解,即首先使用有标记样本集训练出一个初始SVM,接着使用该学习器对未标记样本进行打标,这样所有样本都有了标记,并基于这些有标记的样本重新训练SVM,之后再寻找易出错样本不断调整。整个算法流程如下所示:
其中
输入:有标记样本集
;
未标记样本集;
折中参数
过程:
1: 用训练一个 (初始SVM);
2: 用对 中样本进行预测,得到
3: 初始化
4: whiledo 5: 基于 求解式(1),得到
6: whiledo(松弛变量越大表示离超平面越近,越容易分错)
7: $\hat{y}_i = -\hat{y}_i $
8: $\hat{y}_j = -\hat{y}_j $
9: 基于重新求解式(1),得到
10: end while
11:(逐渐增大 )
12: end while
输出:未标记样本的预测结果:(最终调整后的结果)
基于分歧的方法
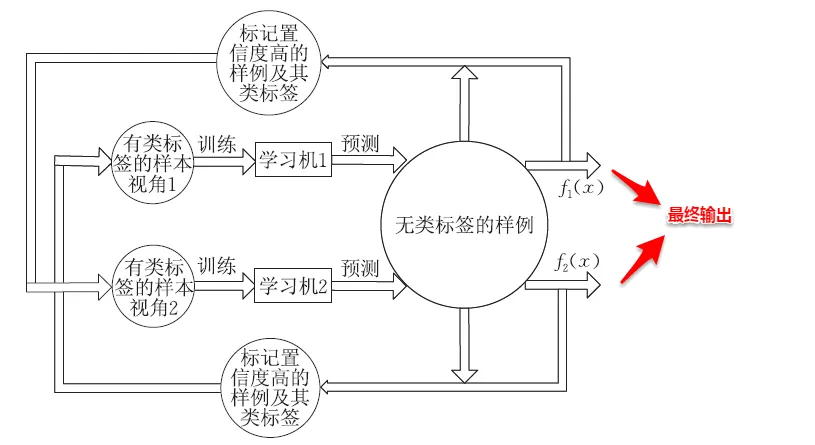
基于分歧的方法通过多个学习器之间的分歧(disagreement)/多样性(diversity)来利用未标记样本数据,协同训练就是其中的一种经典方法。协同训练最初是针对于多视图(multi-view)数据而设计的,多视图数据指的是样本对象具有多个属性集,每个属性集则对应一个试图。例如:电影数据中就包含画面类属性和声音类属性,这样画面类属性的集合就对应着一个视图。首先引入两个关于视图的重要性质:
- 相容性:即使用单个视图数据训练出的学习器的输出空间是一致的。例如都是
、 等。
- 互补性:即不同视图所提供的信息是互补/相辅相成的,实质上这里体现的就是集成学习的思想。
协同训练正是很好地利用了多视图数据的“相容互补性”,其基本的思想是:首先基于有标记样本数据在每个视图上都训练一个初始分类器,然后让每个分类器去挑选分类置信度最高的样本并赋予标记,并将带有伪标记的样本数据传给另一个分类器去学习,从而你依我侬/共同进步。
输入:有标记样本集
;
未标记样本集;
缓冲池大小;
每轮挑选的正例数;
每轮挑选的负例数;
基学习算法;
学习轮数; 过程:
1: 从中随机抽取 个样本构成缓冲池 (设置缓冲池,减少了每轮计算置信度的次数)
2:
3: fordo
4:(各视图的有标记样本)
5: end for
6: fordo
7: fordo
8:(基于每个视图训练初始学习器)
9: 考察在 上的分类置信度,挑选 个正例置信度最高的样本 、 个反例置信度最高的样本 ;
10: 由生成伪标记正例 ;
11: 由生成伪标记反例 ;
12:(两个学习器挑选的不会有重复)
13: end for
14: if均未发生改变 then
15: break
16: else
17: fordo
18:(加入打过伪标的未标记样本)
19: end for
20: 从中随机抽取 个样本加入 (补充缓冲池)
21: end if
22: end for
输出:分类器(最终输出两个分类器做集成)
13.4 半监督聚类
前面提到的几种方法都是借助无标记样本数据来辅助监督学习的训练过程,从而使得学习更加充分/泛化性能得到提升;半监督聚类则是借助已有的监督信息来辅助聚类的过程。一般而言,监督信息大致有两种类型:
- 必连与勿连约束:必连指的是两个样本必须在同一个类簇,勿连则是必不在同一个类簇。
- 标记信息:少量的样本带有真实的标记。
下面主要介绍两种基于半监督的K-Means聚类算法:第一种是数据集包含一些必连与勿连关系,另外一种则是包含少量带有标记的样本。两种算法的基本思想都十分的简单:对于带有约束关系的k-均值算法,在迭代过程中对每个样本划分类簇时,需要检测当前划分是否满足约束关系,若不满足则会将该样本划分到距离次小对应的类簇中,再继续检测是否满足约束关系,直到完成所有样本的划分。算法流程如下图所示:
输入:样本集
必连约束集合;
勿连约束集合;
聚类簇数
过程:
1: 从中随机选取 个样本作为初始均值向量
2: repeat
3:;
4: fordo
5: 计算样本与各均值向量 的距离: ;
6:;
7: is_merged=false
8: while !is_merged do
9: 基于找出与样本 距离最近的簇:
10: 检测将划入聚类簇 是否会违背 与 中的约束;
11: if !is_voilated then
12:
13: is_merged=true
14: else
15:(若不满足则虚招距离次小的类簇)
16: ifthen
17: break并返回错误提示
18: end if
19: end if
20: end while
21: end for
22: fordo
23:
24: end for
25: until 均值向量均未更新
输出:簇划分
其中8-20表示对样本进行划分时,需检测是否满足约束关系,其他步骤均相同。
对于带有少量标记样本的k-均值算法,则可以利用这些有标记样本进行类中心的指定,同时在对样本进行划分时,不需要改变这些有标记样本的簇隶属关系,直接将其划分到对应类簇即可。算法流程如下所示:
输入:样本集
;
少量有标记样本;
聚类簇数
过程:
1: fordo
2:
3: end for
4: repeat
5:
6: fordo
7: for alldo
8:
9: end for
10: end for
11: for alldo
12: 计算样本与歌均值向量 的距离: ;
13: 找出与样本距离最近的簇:
14: 将样本划入相应的簇: (划分无标记样本)
15: end for
16: fordo
17:;(重新计算类中心)
18: end for
19: until 均值向量均未更新
输出:簇划分
上面算法过程中,1-3表示使用带标记样本各类别的均值向量作为初始类中心,6-10表示带标记样本直接划入对应类簇。